Object Detection
Esegue il rilevamento oggetti YOLO sulle immagini — restituisce gli oggetti rilevati con bounding box.
Il modulo Object Detection esegue un modello di rilevamento oggetti YOLO su un’immagine di input. Restituisce una lista di oggetti rilevati con bounding box e punteggi di confidenza.
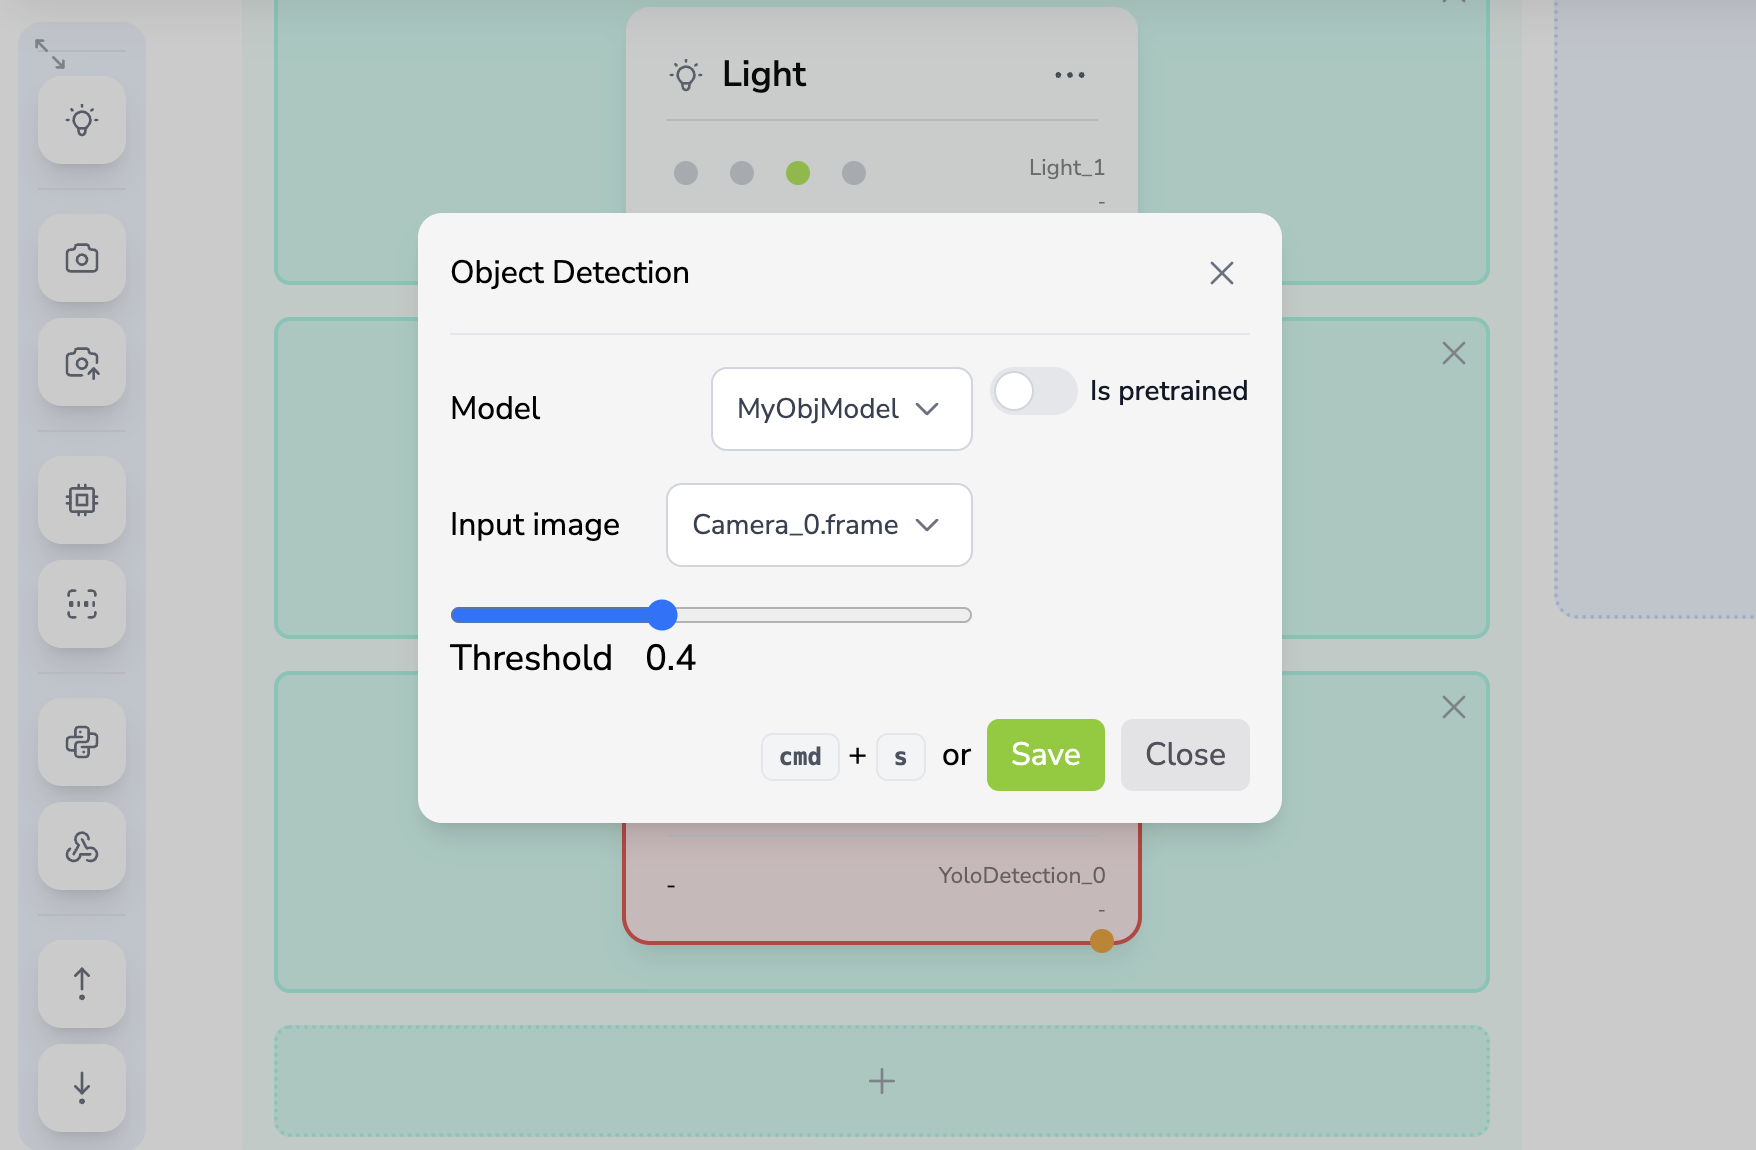
Configurazione
| Campo | Tipo | Descrizione |
|---|---|---|
| Model | string |
Il modello YOLO da usare. Selezionane uno dal menu a tendina, oppure clicca sul pulsante + per registrare un nuovo modello. |
| Input image | string |
La chiave del registro dati dell’immagine di input (es. Camera_0.frame). Selezionane una dal menu a tendina. |
| Threshold | float |
Soglia di confidenza per i rilevamenti. Default: 0.4. L’unico slider imposta sia la soglia minima sia quella massima allo stesso valore. |
| Is pretrained | boolean |
Quando true, il modulo esegue sempre l’inferenza indipendentemente dalla modalità di esecuzione. Quando false, l’inferenza viene eseguita solo in modalità inferenza (e viene saltata in modalità acquisizione). |
Nell’editor, i campi Model e Input image appaiono come menu a tendina. Il menu a tendina Model include un pulsante + che ti permette di registrare un nuovo modello direttamente dall’editor. Il controllo della soglia appare come un unico slider etichettato Threshold; al salvataggio, il valore dello slider viene scritto sia nel campo della soglia minima sia in quello della soglia massima.
Comportamento
In modalità Inferenza (o quando is_pretrained = true):
- Legge l’immagine di input dal registro dati.
- Esegue il modello di rilevamento YOLO con le soglie configurate.
- Supporta le Oriented Bounding Boxes (OBB) in aggiunta ai box di segmentazione standard. Quando sono disponibili risultati OBB, questi vengono usati; altrimenti vengono usati i risultati di segmentazione.
- Restituisce una lista di oggetti rilevati.
In modalità Acquisizione (quando is_pretrained = false):
- Legge l’immagine di input.
- Salta l’inferenza — l’immagine viene salvata nel dataset per l’addestramento.
Alcuni modelli (es. barcode) hanno un flag forced_pretrained che imposta automaticamente is_pretrained = true e disabilita l’interruttore. Questo garantisce che il modello esegua sempre l’inferenza indipendentemente dalla modalità di esecuzione.
Input e Output
| Direzione | Chiave | Tipo | Descrizione |
|---|---|---|---|
| Input | <image_name> (es. Camera_0.frame) |
image |
L’immagine da analizzare |
| Output | <module_id>.detected |
list |
Lista di oggetti rilevati con bounding box e punteggi |
![esempio di possibile output ###missing screen]
Vincoli di Esecuzione
| Vincolo | Supportato |
|---|---|
| Sempre | ✅ |
| Acquisizione | ✅ |
| Inferenza | ✅ |
Questo modulo richiede un’immagine prodotta da un modulo telecamera in un blocco precedente. Il campo image_name deve fare riferimento a una chiave di output valida da un blocco precedente.
Quando is_pretrained è false e il sistema è in modalità acquisizione, non viene prodotto alcun risultato di inferenza. L’immagine viene comunque memorizzata per l’addestramento. Le Pipeline che dipendono dall’output di inferenza dovrebbero impostare il vincolo di esecuzione su Inferenza sui moduli a valle che dipendono dai risultati dell’inferenza.