Struttura della pipeline
Comprendi come pipeline, blocchi e registro dati lavorano insieme.
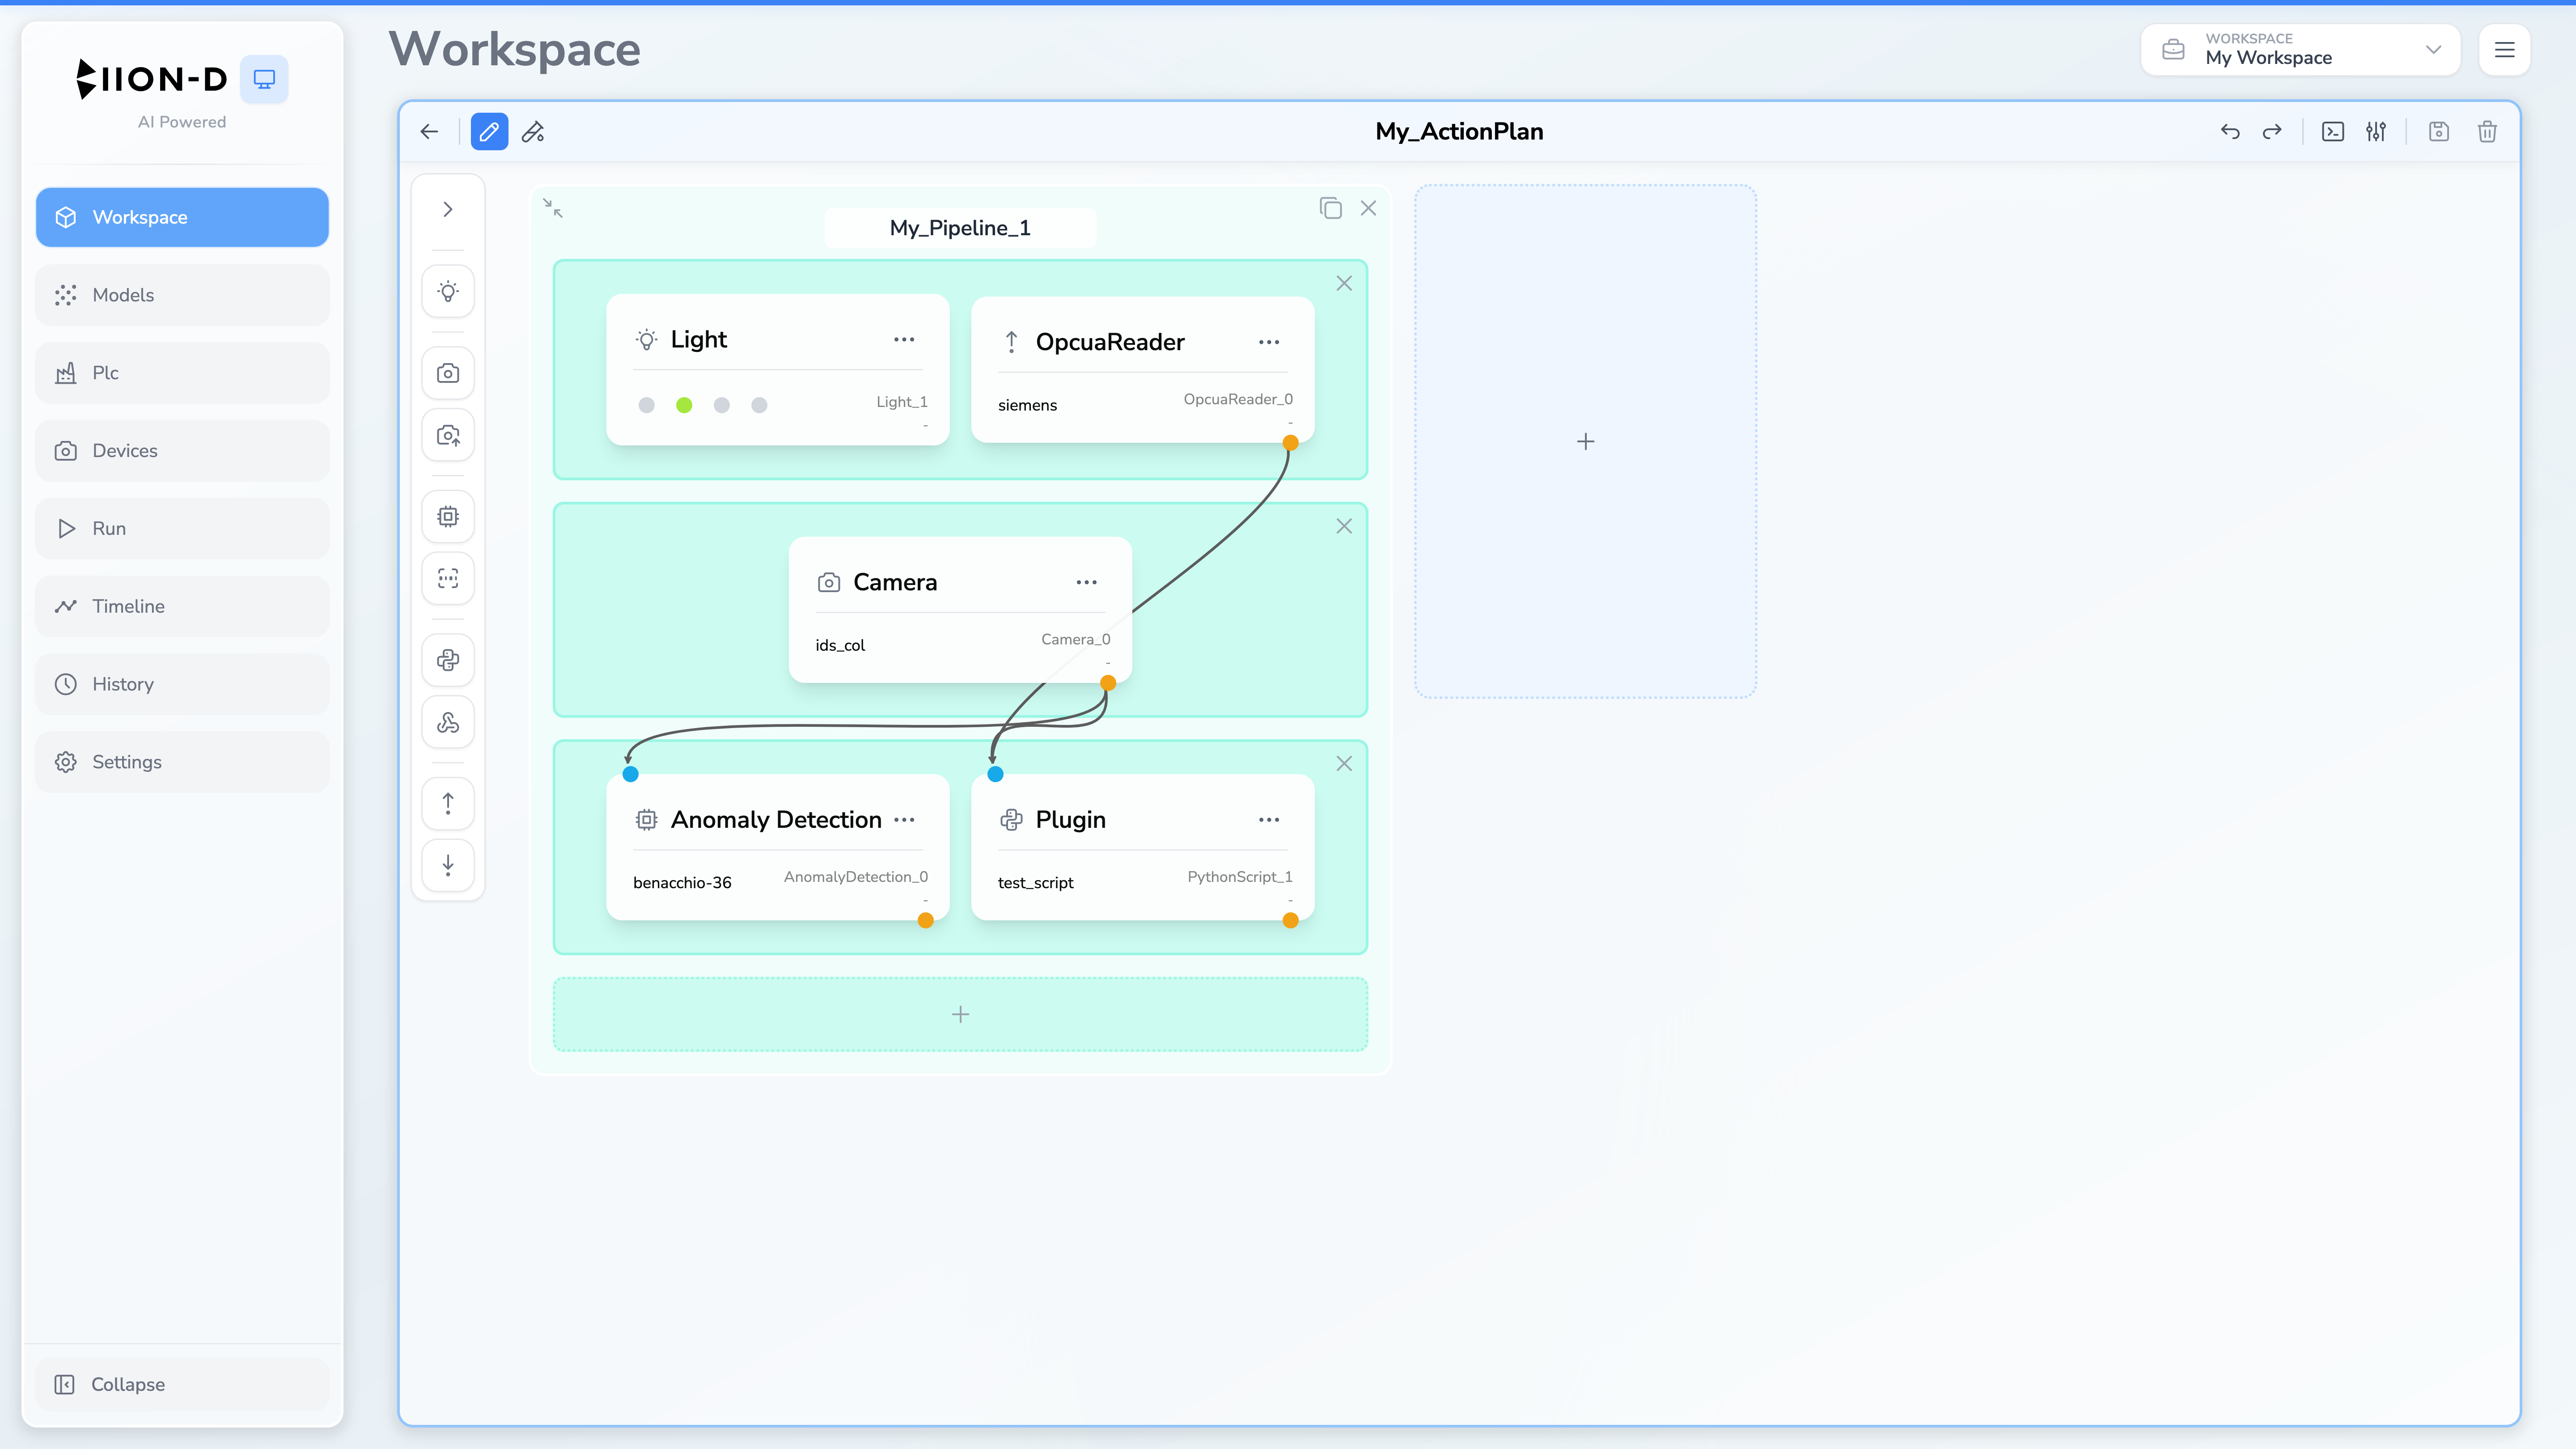
Una pipeline è l’unità di esecuzione principale di BIION-D. Definisce una sequenza di operazioni, dall’acquisizione dell’immagine all’inferenza AI fino all’output dei risultati. Questa pagina spiega l’architettura delle pipeline e il modo in cui vengono validate.
Concetti chiave
| Concetto | Descrizione |
|---|---|
| Pipeline | Una sequenza di blocchi che elabora dati dall’input, ad esempio le telecamere, fino all’output dei risultati. |
| Blocco | Una riga di moduli eseguiti in parallelo. I blocchi vengono eseguiti in sequenza, dall’alto verso il basso. |
| Modulo | Una singola operazione: acquisire un’immagine, eseguire inferenza, controllare una luce, eseguire uno script o comunicare con un PLC. |
| Data Registry | I valori prodotti durante un’esecuzione e resi disponibili ai moduli dei blocchi successivi. |
Blocchi
I blocchi sono le righe della pipeline e impongono l’ordine di esecuzione:
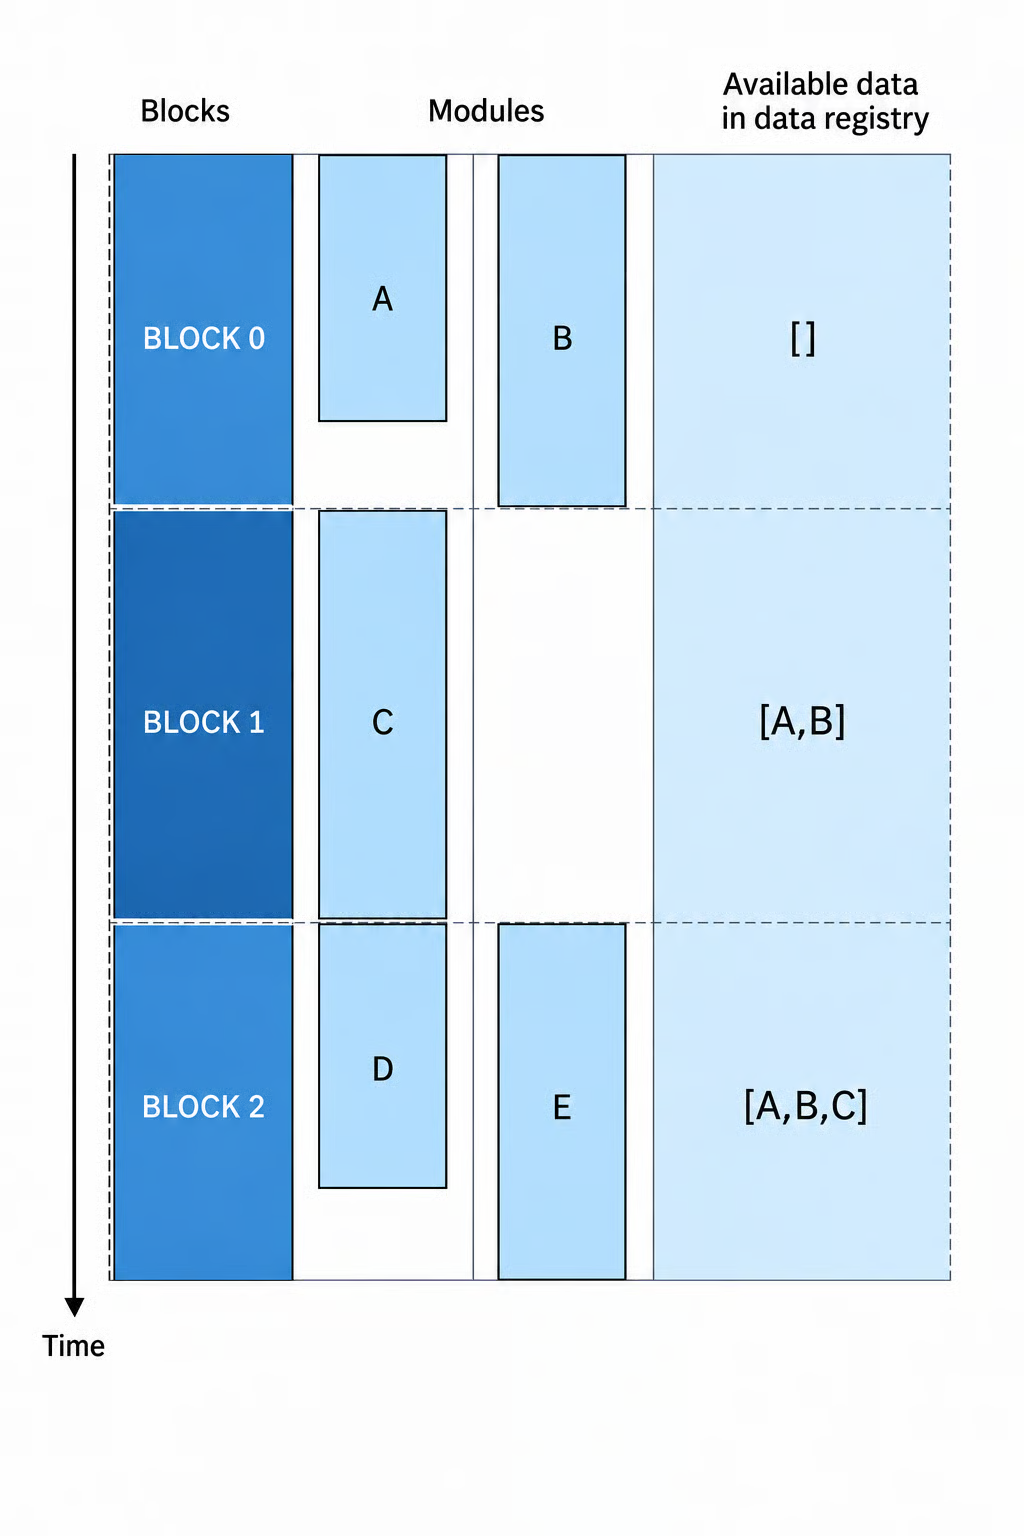
- Il Blocco 0 viene eseguito per primo: tutti i suoi moduli vengono eseguiti in parallelo.
- Il Blocco 1 viene eseguito dopo il completamento del Blocco 0: tutti i suoi moduli vengono eseguiti in parallelo.
- Il ciclo continua allo stesso modo per i blocchi successivi.
Questo design permette di:
- Eseguire più telecamere in parallelo nello stesso blocco.
- Assicurarsi che le luci siano configurate prima dell’acquisizione delle telecamere, usando blocchi diversi.
- Eseguire più inferencer su immagini diverse contemporaneamente nello stesso blocco.
Data Registry
Il Data Registry contiene gli output prodotti durante una singola esecuzione della pipeline. I valori usano la notazione con il punto, per esempio Camera_0.frame o AnomalyDetection_0.pred_score. Le finestre di configurazione mostrano solo gli input disponibili nei blocchi precedenti.
Campi predefiniti
Ogni esecuzione della pipeline inizia con questi campi obbligatori:
| Campo | Default | Descrizione |
|---|---|---|
compliance |
0 (Good) |
Conformità complessiva del risultato della pipeline. Viene aggiornata automaticamente dai moduli inferencer. |
Accesso ai dati dagli script Python
Write:  Data.export("custom_value", 123.3)
Read:   Data.get("camera_0.frame")  → image
Read:   Data.get("camera_0.execution_time")  → 12.5
Force compliance: Data.set_compliance(COMPLIANT) # COMPLIANT, UNCERTAIN, DEFECTED
Nomi riservati
I seguenti ID di pipeline sono riservati e non possono essere utilizzati:
overall_compliancecomplianceoverall_compliance_overridecompliance_override
Caratteri non validi
Gli ID delle pipeline non possono contenere: ., /, ...
Regole di validazione
BIION-D valida automaticamente le pipeline durante la creazione e prima dell’esecuzione. Esistono due livelli di validazione:
Regole a livello di blocco
Queste regole si applicano ai moduli all’interno dello stesso blocco:
| Regola | Descrizione |
|---|---|
| Esclusione multicamera | Due moduli Camera con la stessa cam_label non possono trovarsi nello stesso blocco, perché la stessa telecamera fisica non può acquisire due volte contemporaneamente. |
| Esclusione luce-camera | Un modulo Light e un modulo Camera non possono coesistere nello stesso blocco: le luci devono essere impostate prima dell’acquisizione. |
| Massimo una luce per blocco | In ogni blocco è consentito un solo modulo Light. |
| Validazione del vincolo di esecuzione | Il vincolo di esecuzione di ogni modulo deve appartenere all’elenco dei vincoli consentiti per il relativo tipo. |
Regole a livello di pipeline
Queste regole si applicano a tutti i blocchi della pipeline:
| Regola | Descrizione |
|---|---|
| Soddisfacimento delle dipendenze di input | Gli input dichiarati da ogni modulo devono essere forniti dagli output dei moduli nei blocchi precedenti. |
| ID modulo univoci | Ogni modulo della pipeline deve avere un ID univoco. |
Se la validazione fallisce, la pipeline non può essere testata o eseguita. L’editor identifica la configurazione interessata. Una bozza può comunque essere salvata: risolvi gli errori di validazione prima dell’uso in produzione.
Modalità di esecuzione
Le pipeline supportano due modalità di esecuzione:
Modalità Frame
È la modalità predefinita. Ogni pipeline viene eseguita una volta, elabora un singolo insieme di frame e restituisce i risultati.
Modalità Stream
È la modalità di esecuzione continua. La pipeline elabora i frame finché non viene arrestata. Un Action Plan in streaming contiene esattamente una pipeline.
- L’Action Plan può contenere una sola pipeline.
- I risultati vengono messi in coda e consumati dal client.
Aggregazione dell’Action Plan
Quando tutte le pipeline di un Action Plan sono state completate, i loro risultati vengono aggregati.
Logica di aggregazione: BAD_UNC_GOOD
La conformità complessiva viene determinata dal risultato peggiore tra tutte le pipeline:
| Pipeline 1 | Pipeline 2 | Complessivo |
|---|---|---|
| Good (0) | Good (0) | Good (0) |
| Good (0) | Uncertain (1) | Uncertain (1) |
| Good (0) | Defected (2) | Defected (2) |
| Uncertain (1) | Defected (2) | Defected (2) |
In questo modo, se una pipeline rileva un difetto, l’intero Action Plan viene contrassegnato come difettoso.